
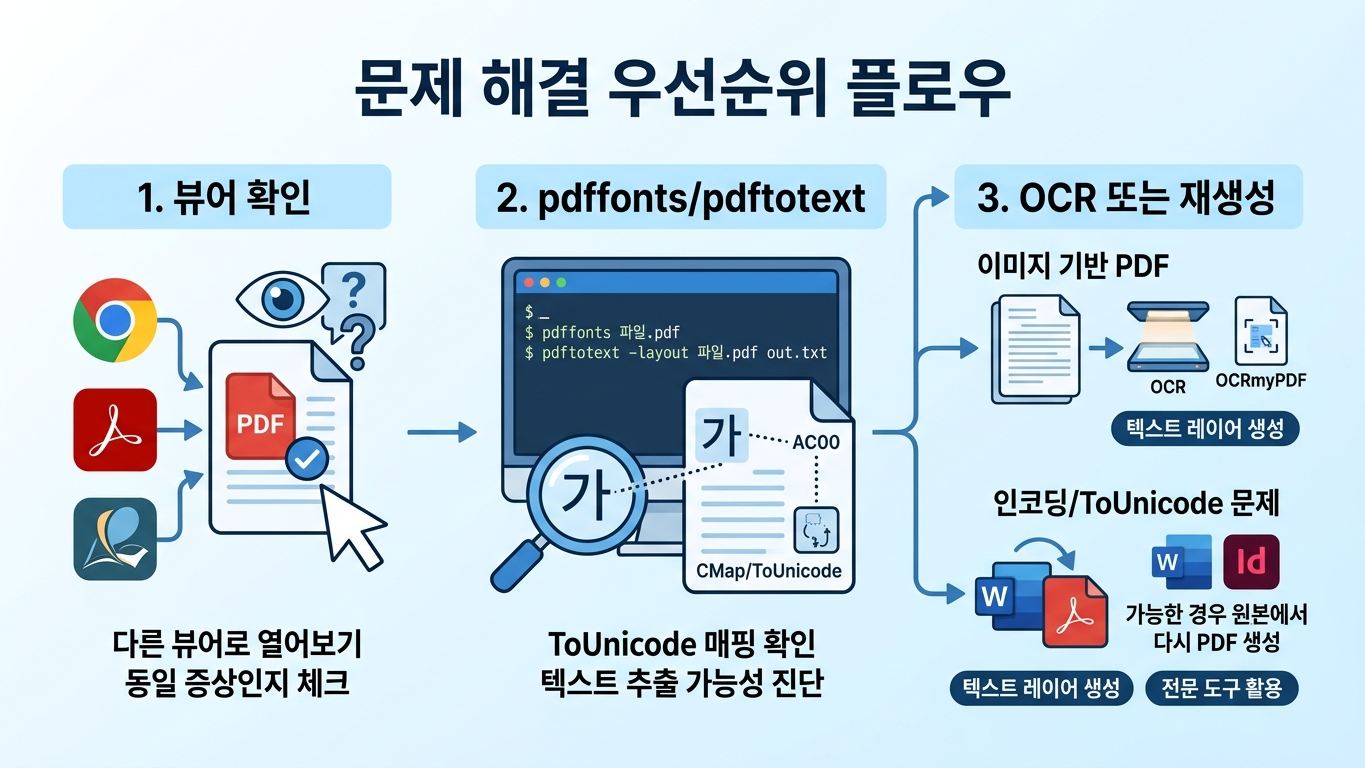
PDF 글자가 화면에서는 정상인데 복사하면 깨진다면, 먼저 복사 권한 문제인지, 문자 매핑 문제인지, 스캔 이미지인지를 구분하세요. 모든 파일에 OCR부터 적용하면 불필요하게 문서를 변환하거나 정상 텍스트를 손상시킬 수 있습니다.
이 글에서 바로 찾기 5개 항목
원본을 보관하고 문제가 있는 한 페이지만 비교합니다
다른 뷰어에서도 같은 문장을 복사해 메모장에 붙여 넣어 보세요. 문서 속성의 보안 항목에서 복사·추출 권한을 확인하고, 제한이 있다면 문서 제공자에게 허용된 원본이나 접근 방법을 요청합니다. 회사 문서·계약서·개인정보 문서는 임의의 온라인 변환기에 올리지 마세요.
전자서명이 있는 PDF는 OCR 전에 멈춰 확인하세요. OCRmyPDF는 서명을 유지한 채 OCR을 추가할 수 없어 기본적으로 서명된 문서의 수정을 거부합니다. 원본은 보존하고 제공자에게 검색 가능한 별도 사본을 요청하세요. 전자서명 문서의 공식 제한사항을 먼저 확인하는 편이 안전합니다.
| 증상 | 먼저 확인할 것 |
|---|---|
| 글자를 선택할 수 없음 | 스캔 이미지인지 확인합니다. 선택 불가만으로 권한 문제를 확정하지 않습니다. |
| 선택되지만 다른 문자로 복사됨 | 문자 코드와 글리프의 연결, 기존 OCR 레이어를 확인합니다. |
| 한 뷰어에서만 깨짐 | 다른 뷰어의 복사 결과와 업데이트 상태를 비교합니다. |
| 복사 명령 자체가 제한됨 | 문서 보안·이용 권한을 확인합니다. |
Poppler로 폰트와 추출 결과를 확인합니다
아래 명령은 Poppler의 pdffonts와 pdftotext가 설치된 Linux·macOS·WSL 터미널용입니다. Windows 기본 명령이 아닙니다. 패키지 이름은 Linux 배포판에 따라 다르며, Debian·Ubuntu에서는 보통 poppler-utils 패키지에 들어 있습니다.
pdffonts "input.pdf"
pdftotext -f 1 -l 1 -layout -enc UTF-8 "input.pdf" "page-1.txt"
두 번째 명령은 첫 페이지만 추출해 새 텍스트 파일에 저장합니다. 출력 파일 이름이 기존 파일과 겹치지 않는지 먼저 확인하세요. 원본 PDF는 변경하지 않습니다.
pdffonts의 uni=yes는 명시적인 ToUnicode 매핑이 있다는 뜻이지 내용이 모두 정확하다는 뜻은 아닙니다. 반대로 uni=no여도 다른 인코딩 정보로 복사 가능한 문서가 있으므로 그 값만으로 결함을 판정하지 않습니다. pdffonts 매뉴얼과 실제 추출 결과를 함께 보세요.
문자는 맞는데 읽는 순서가 이상하면 다단 편집·표 구조가 원인일 수 있습니다. -layout을 뺀 결과도 별도 파일로 비교합니다. pdftotext 옵션 문서는 레이아웃 보존과 추출 모드의 차이를 설명합니다.
텍스트 파일이 만들어지지 않으면 종료 코드를 봅니다
pdftotext -f 1 -l 1 -layout -enc UTF-8 "input.pdf" "page-1-check.txt"
printf 'exit code: %s\n' "$?"
Bash에서 두 번째 줄은 바로 앞 명령의 종료 코드를 표시합니다. 사이에 다른 명령을 실행하지 마세요. pdftotext의 종료 코드는 다음처럼 구분합니다.
- 1: 입력 PDF 열기 실패입니다. 파일명·경로와 오류 메시지를 확인합니다.
- 2: 출력 파일 열기 실패입니다. 저장 폴더가 있는지, 쓰기 가능한지 확인합니다.
- 3: PDF 권한 관련 오류입니다. 제한을 우회하지 말고 제공자에게 허용된 사본을 요청합니다.
- 99: 기타 오류입니다. 터미널 오류 메시지를 보관해 원인을 좁힙니다.
종료 코드가 0이어도 문자와 읽기 순서가 정확하다는 뜻은 아닙니다. 새 텍스트 파일을 열어 문제 문장과 대조해야 합니다.
한국어 스캔이라면 언어 데이터를 확인한 뒤 OCR합니다
OCRmyPDF와 Tesseract가 설치되어 있고, 한국어 kor·영어 eng 언어 데이터가 있어야 아래 예제를 사용할 수 있습니다. 설치 방식은 운영체제마다 다르므로 OCRmyPDF 설치 문서를 먼저 확인하세요.
tesseract --list-langs
ocrmypdf -l kor+eng "input.pdf" "output-ocr.pdf"
pdftotext -layout -enc UTF-8 "output-ocr.pdf" "output-ocr.txt"
첫 명령의 언어 목록에 kor가 없다면 먼저 한국어 데이터를 설치해야 합니다. 파일을 만들었다고 인식이 정확한 것은 아닙니다. 이름·금액·날짜·계좌번호처럼 한 글자 오류가 중요한 항목을 원본과 직접 대조하세요. 언어 코드는 Tesseract 지원 언어 목록에서 확인할 수 있습니다.
긴 문서는 문제 페이지부터 처리합니다
ocrmypdf --pages 1 --output-type pdf --optimize 0 -l kor+eng "input.pdf" "page-1-ocr.pdf"--pages 1은 첫 페이지만 OCR 대상으로 고르며 나머지 페이지를 삭제하는 옵션은 아닙니다. 페이지 번호는 인쇄된 쪽수가 아니라 파일의 첫 장부터 셉니다. 위 명령은 PDF/A 변환과 최적화를 끄지만 원본과 바이트 단위로 같은 파일을 보장하지는 않습니다. 기존 텍스트가 있다는 오류가 나오면 아래 절차로 구분하세요. 페이지 선택과 문서 전체 처리의 차이를 참고할 수 있습니다.
이미 텍스트가 있다는 오류가 나오면 멈춰 구분합니다
문서에 텍스트 레이어가 이미 있으면 기본 OCR 명령이 중단될 수 있습니다. 스캔 페이지와 정상 텍스트 페이지가 섞였을 때는 다음처럼 기존 텍스트 페이지를 건너뛰는 방식을 검토합니다.
ocrmypdf --skip-text -l kor+eng "mixed.pdf" "mixed-ocr.pdf"이 명령은 이미 있지만 잘못된 텍스트를 고치는 방법이 아닙니다. 그런 페이지는 그대로 건너뛸 수 있습니다. OCRmyPDF 17에서는 같은 동작을 --mode skip으로도 지정할 수 있습니다. 공식 사용 예제에서 설치 버전에 맞는 옵션을 확인하세요.
스캔 위의 기존 OCR 레이어가 잘못됐다면 --redo-ocr를 검토할 수 있습니다. 정상 디지털 텍스트는 건너뛰고 감지되는 OCR을 다시 처리하는 방식이므로, 일반 텍스트의 ToUnicode 문제를 모두 고치는 옵션은 아닙니다. 기존 OCR을 감지하지 못하는 파일도 있습니다. OCR 재처리의 적용 범위를 확인한 뒤 별도 출력 파일로 비교하세요.
강제 OCR은 원래 벡터·텍스트를 래스터화할 수 있어 기본 해결책으로 권하지 않습니다. 원본 Word·편집 파일이 있다면 텍스트를 유지해 PDF를 다시 만드는 편이 낫습니다. 폰트를 포함시키는 것만으로 잘못된 문자 매핑이 항상 고쳐지지는 않습니다.
변환 후에는 네 가지를 확인합니다
- 원본과 출력의 페이지 수가 같은지 확인합니다.
- 문제가 있던 문장을 복사하고 검색해 봅니다.
- 표의 읽는 순서와 금액·날짜·이름을 직접 대조합니다.
- 원본 파일과 출력 파일을 구분해 보관합니다. 전자서명 문서는 변경본의 서명 유효성도 따로 확인합니다.
특정 Chrome 환경에서만 이상하다면 문서를 다시 만들기 전에 브라우저 프로필을 분리해 비교하는 방법으로 뷰어 문제부터 좁힐 수 있습니다.
PDF 복사 오류는 “OCR하면 끝”인 문제가 아닙니다. 권한을 확인하고, 추출 결과로 원인을 나눈 뒤, 필요한 페이지만 처리하고 정확도를 검증하는 순서가 불필요한 변환을 줄여 줍니다.